Discussion: 每日新闻
据存储专业媒体StorageReview.com报道,2026年10月15日,三星在加州圣何塞举行的OCP全球峰会上,公开了一组与AMD联合验证的三星CXL内存池演示。该演示基于CMM-D CXL内存模块,面向智能体AI推理负载,宣称相比静态内存分配可将首令牌时延(TTFT)降低最多38%,有效吞吐量提升最多3.3倍。这一结果成为峰会内存与计算融合话题的焦点之一。
法治新闻CXL内存池架构:弹性分配取代静态峰值配置
三星此次展示的池化方案跑在一个GPU服务器上,模拟AI代理工作负载,背后采用CXL动态容量设备(DCD)语义。DCD允许内存池在运行时把容量动态交给某个主机,也能在任务结束后收回。多个LLM实例在池中共享内存:当某个实例遇到上下文窗口或参数突增,它临时借入空闲容量,完成后立即归还。三星表示,这种方式改变了以往按节点峰值“一次性买断”的做法,免去了闲置内存浪费。官方给出的对比数据是:最高38%的TTFT下降,以及最高3.3倍的良好吞吐提升。需要强调的是,这些数字来自三星的演示测量,StorageReview.com并未独立复测或审计。
民生新闻AMD联合验证:核心数增长与CPU停滞难题
三星与AMD的联合验证,目标很明确:在AMD计算平台上解决智能体AI负载带来的CPU停滞。三星指出,智能体类应用会让CPU利用率剧烈上升,但内存容量和带宽往往跟不上核心数的增长,导致处理器空转。CMM-D通过CXL内存池化让容量和带宽随核心数同步扩展,从而最大化并发用户数。不过,双方未公布服务器配置、CXL交换拓扑、互连延迟与带宽等关键参数。另据路透社报道,行业内普遍认为,这类跨厂商验证是CXL从实验室走向实际部署的重要一步。10月15日,三星还与XCENA共同主持了一场围绕动态池化、共享内存与近内存处理卸载的技术会议,进一步展示多主机共享能力。
本地新闻生产环境回声:AI Memory Node与L3.5分级
除了展台的演示环境,三星还给出了一个正在运行的生产数据点。部署在三星半导体美国园区的“AI Memory Node with CMM-D”正在服务内部AI编程代理等日常应用。三星表示,在加入其称为L3.5的可组合内存层后,KV缓存利用率提升了5倍到7倍。该成果来自三星内存解决方案实验室、AI平台集成团队以及SGLang开源社区的合作。生产环境的数据说明,CMM-D内存池并不只是演示道具,而是已经进入实际业务负载,并能为后续产品化提供参考。
地方新闻高管定调:从HBM到SSD的完整内存分层
10月12日,三星内存业务应用工程团队负责人、企业副总裁Hojun Shim发表了题为“扩展AI时代创新:让计算满负荷运行”的高管演讲。他在现场表示:“随着模型规模扩大,单纯的内存速度并不能让计算资源持续忙碌,关键在于构建分层体系:高带宽内存承担活跃计算,CXL池按需扩容,SSD承载KV缓存与模型持久化。”10月13日,三星的Jinin So与Youngha Choi接着在“为智能体内存分层:从CXL池化到SSD背书的KV缓存卸载”会议上展开阐述。这一分层思路与StorageReview此前测试的KV缓存闪存卸载方向一致,也反映出三星希望把存储产品线“编织”进AI推理的内存体系。
头条新闻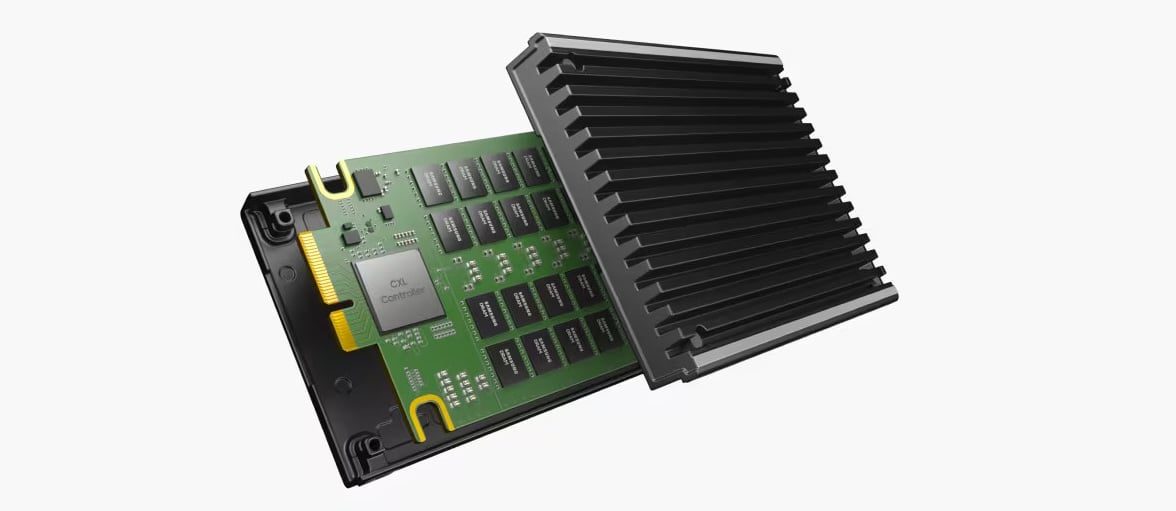
Tokenization新品:HBM4E与LPDDR5X-PIM
在“分词解决方案”一侧,三星展示了HBM4E和LPDDR5X-PIM。HBM4E的12层样品从2026年5月起向客户提供,并于8月的FMS 2026上与HBM5模型一同亮相。LPDDR5X-PIM则在每个DRAM bank内置了处理单元,将推理中受带宽限制的运算移入内存内部执行。三星在自研Edge AI Accelerator上基于Llama 3.1 8B模型评测,宣称PIM可提供最高8倍的有效带宽,以及最高3倍的每秒生成token数。“PIM的关键是让更多运算留在DRAM内部,减少穿越互连的数据量。”三星相关负责人表示。据韩联社此前报道,三星计划优先将PIM用于边缘AI场景,服务器端时间表尚未披露。
硬件阵容商用化现状:哪些已量产,哪些仍是演示
从现场阵容看,CMM-D MD310、PM1763 Gen6 SSD以及BM1773(256TB E3.S QLC)都是量产部件。PM1763顺序读取最高28.4GB/s,并在展台展示了液冷版本;BM1773被三星称为首款256TB E3.S QLC SSD。相比之下,CXL内存池与AMD的联合方案还没有对应SKU、可用日期或功耗参数,属于技术验证。三星同时还演示了AiSIO加速器直存方案,宣称可提供100M IOPS以及最高10倍的冷启动模型加载速度。以下表格汇总了本届峰会展示的核心产品状态:
| 项目 | 状态 | 关键数据/说明 |
|---|
| --- | --- | --- |
|---|
| 与AMD的CXL池化演示 | 技术演示 | 最高-38% TTFT、最高3.3倍goodput(三星数字) |
|---|
| CMM-D MD310 | 已量产 | CXL内存扩展模块,支持池化 |
|---|
| PM1763 Gen6 SSD | 已量产 | 顺序读取最高28.4GB/s,液冷展示 |
|---|
| BM1773 | 已量产 | 256TB E3.S QLC SSD |
|---|
| HBM4E 12层 | 已送样 | 2026年5月起客户评估 |
|---|
| LPDDR5X-PIM | 无时间表 | 宣称最高8倍有效带宽、3倍tokens/s(Llama 3.1 8B) |
|---|
| AiSIO | 技术演示 | 100M IOPS,冷启动加载最高10倍(三星数字) |
|---|
常见问题:关于三星CXL内存池
Q1:CXL内存池与静态内存分配的核心差别是什么?
A1:CXL内存池基于DCD语义,可在运行时把内存动态分配给不同主机或LLM实例,任务结束后再收回。传统静态分配按节点峰值配置,节点间无法共享余量,易造成大量内存闲置;池化能“削峰填谷”,让多个智能体共享同一份内存资源,提高利用率。
Q2:这项技术什么时候能买到?
A2:三星尚未公布CXL池控制器的SKU、上市时间或功耗参数,因此整套池化方案仍属技术验证。不过CMM-D MD310、PM1763、BM1773等组件已经量产销售,用户可先行搭建基于CXL的内存扩展与分层存储,但控制器和软件生态仍需等待后续商用计划。
三星与AMD在本届OCP峰会上的三星CXL内存池演示,再次将CXL生态从概念推至工程验证前沿。38%、3.3倍与5至7倍等数字仍需第三方复测,但HBM、CXL池与SSD构成的三级内存体系,已成为应对智能体AI推理内存压力的明确方向。业界期待三星尽快公布更完整的商用时间表与互操作细节。
Related Threads - 姐弟恋情
三星CXL内存池在OCP 2026峰会上完成与AMD的联合验证,宣称智能体AI推理首令牌时间最多降低38%、有效吞吐提升3.3倍。本文详解基于CMM-D的内存池化架构、KV缓存分层实践、HBM4E与LPDDR5X-PIM进展,并梳理哪些部件已量产、哪些仍停留在演示阶段,帮助读者把握CXL生态商用节奏。



